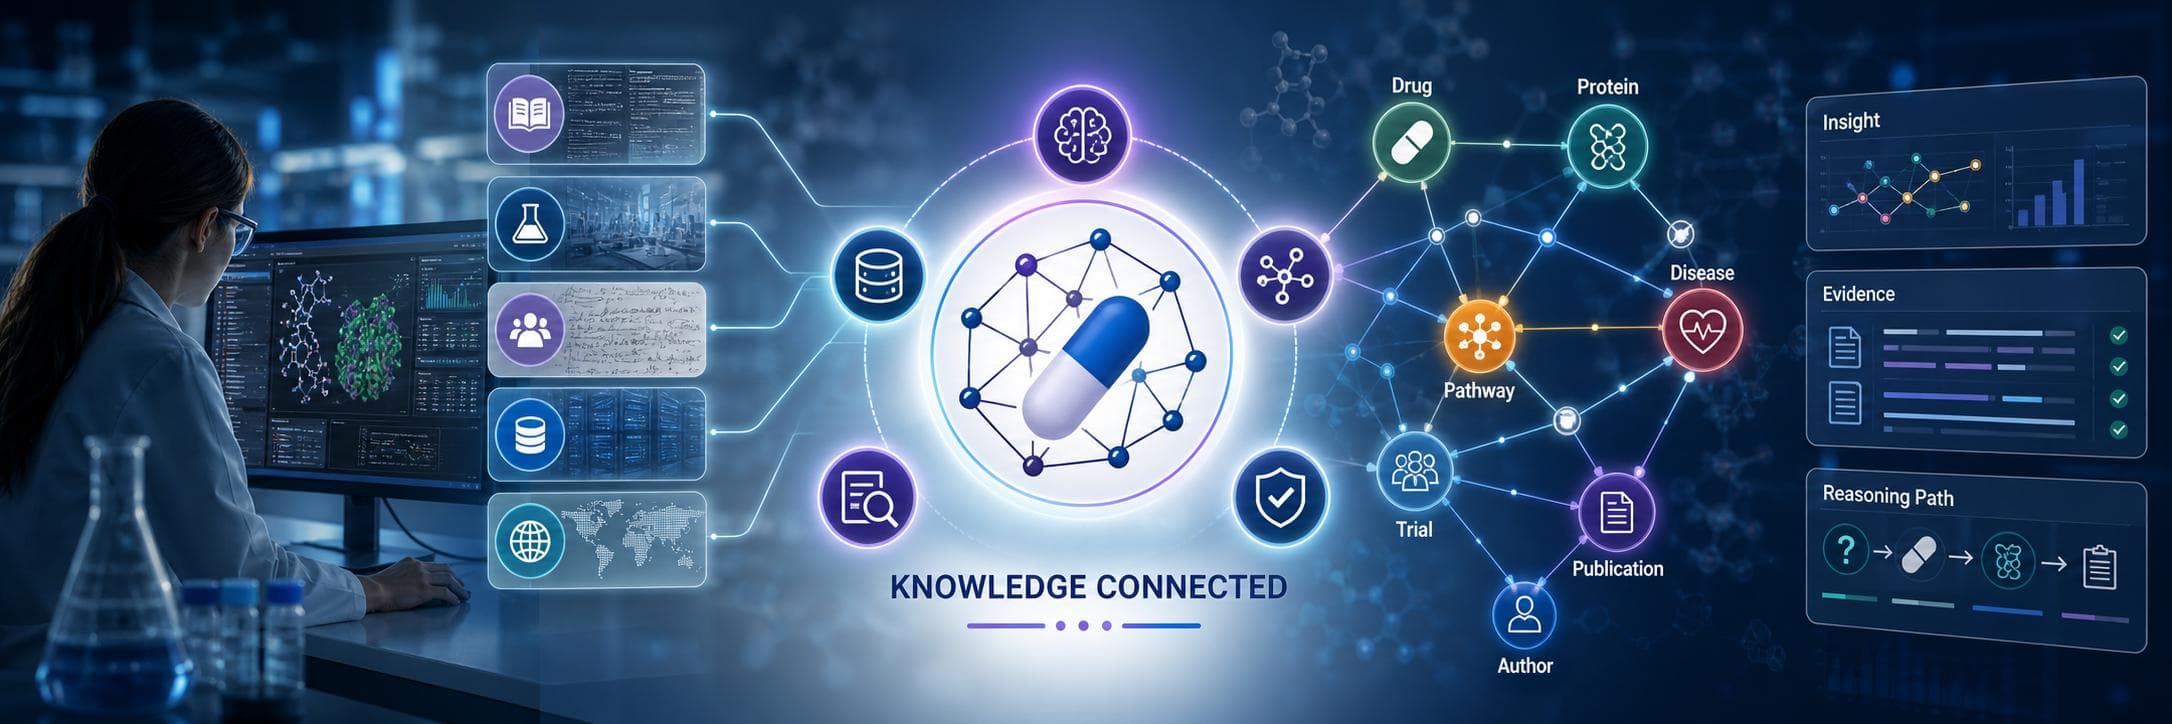
GraphRAG AWS : la recherche pharma accélérée de 87 % via IA
GraphRAG AWS réduit les cycles de recherche pharma grâce à un graphe de connaissances reliant données internes, PubMed et IA générative.
Dans la recherche pharmaceutique, l’accès rapide à une information fiable peut faire gagner des mois. Le déploiement de GraphRAG AWS illustre cette évolution : en reliant des bases propriétaires, des notes de laboratoire et des publications scientifiques dans un même graphe de connaissances, certaines phases de recherche et développement auraient été réduites de 87 %.
L’enjeu n’est pas seulement d’interroger plus vite des documents. Il s’agit de transformer des données dispersées, souvent non structurées, en un réseau vérifiable où chaque réponse générée par l’IA peut être reliée à des sources précises. Pour les équipes scientifiques, cette approche promet des cycles d’hypothèse plus courts, une meilleure traçabilité et une réduction du risque de perte de connaissance interne.
GraphRAG AWS et le défi des données pharmaceutiques
Dans de nombreux environnements pharmaceutiques, les données critiques restent enfermées dans des silos : métriques cliniques, comptes rendus d’expériences, notes d’ingénierie, publications ouvertes ou historiques de projets. Avant ce type d’architecture, les premières phases de collecte et de sélection pouvaient dépasser six mois par itération, avec un taux de succès initial limité.
Le problème est structurel. Les chercheurs doivent rapprocher des informations hétérogènes, parfois rédigées dans des terminologies différentes, puis vérifier leur pertinence scientifique. Lorsque des experts quittent l’organisation, une partie du contexte implicite disparaît avec eux : décisions passées, essais infructueux, hypothèses abandonnées ou signaux faibles observés en laboratoire.
GraphRAG AWS répond à cette fragmentation en combinant un graphe de connaissances avec la génération augmentée par récupération. Les données ne sont plus seulement stockées : elles sont reliées par des entités, des relations et des références documentaires. L’IA peut alors produire une réponse fondée sur un parcours explicite dans le graphe, plutôt que sur une simple recherche textuelle.
Construire un graphe de connaissances exploitable
Le cœur du dispositif repose sur l’intégration de sources internes et externes dans un modèle commun. Des bases publiques comme PubMed peuvent être combinées à des documents d’entreprise, afin d’enrichir les analyses avec des références scientifiques validées et des connaissances propriétaires.
Les documents bruts sont d’abord analysés par des outils de traitement du langage naturel. Des services spécialisés peuvent extraire des codes médicaux, identifier des entités et résumer les contenus. Amazon Bedrock, associé à des modèles de langage, intervient pour générer des synthèses et évaluer la pertinence thématique des documents.
Le graphe obtenu organise ensuite l’information en nœuds et en relations. Les nœuds peuvent représenter des classes médicales, des auteurs, des revues, des fragments de texte ou des concepts cliniques. Les liens décrivent les associations entre ces éléments, par exemple une hiérarchie de classification ou une relation entre une pathologie et un ensemble de publications.
Cette structuration apporte une base plus déterministe à la recherche d’information. Plutôt que de dépendre uniquement de similarités statistiques entre morceaux de texte, le système s’appuie sur des relations explicites et sur une provenance documentaire. C’est un point essentiel pour les usages scientifiques, où une réponse doit pouvoir être auditée.
Une architecture IA modulaire pour interroger le savoir
L’architecture s’appuie sur plusieurs composants cloud. Amazon Neptune Analytics sert à gérer le graphe, tandis qu’Amazon Bedrock fournit la couche de modèles de langage. Selon AWS, ce type d’application GraphRAG peut être conçu avec des bases de connaissances Bedrock et des graphes orientés relations, comme détaillé dans sa documentation sur les applications GraphRAG avec Amazon Bedrock.
Lorsqu’un utilisateur pose une question en langage naturel, un composant de liaison d’entités analyse la requête. Il repère les termes importants, les rapproche des nœuds du graphe et tient compte des variations de vocabulaire. Cette correspondance approximative est indispensable dans un contexte pharmaceutique, où un même concept peut être formulé de plusieurs manières.
Le système traverse ensuite le graphe pour identifier des chemins relationnels plausibles. Le modèle de langage génère une réponse à partir des éléments récupérés, mais celle-ci reste ancrée dans les données disponibles. La modularité de l’ensemble permet aux équipes de modifier le modèle, d’ajuster le schéma du graphe ou d’ajouter de nouvelles sources sans reconstruire toute l’application.
Les fonctions clés peuvent être résumées ainsi :
- initialisation du modèle de langage pour comprendre les requêtes ;
- interface avec le graphe afin de récupérer les nœuds pertinents ;
- liaison d’entités pour relier le langage naturel au schéma structuré ;
- génération de réponses appuyées sur des sources vérifiables ;
- visualisation du chemin de raisonnement pour faciliter l’audit.
Cette séparation des rôles rend l’architecture plus adaptable. Elle aide aussi les équipes techniques à isoler les sources d’erreur, par exemple un mauvais alignement d’entités, une relation de graphe imprécise ou un problème de segmentation documentaire.
Des gains mesurables, mais une gouvernance indispensable
Les premiers indicateurs rapportés sont significatifs. Les cycles de recherche qui nécessitaient auparavant environ six mois pourraient être ramenés à trois semaines. Les vitesses de récupération de données progresseraient de 85 %, tandis que les temps de revue scientifique diminueraient de 70 % grâce à la cartographie automatique des citations.
Ces gains sont particulièrement importants dans la phase exploratoire. Les chercheurs peuvent tester plus rapidement des hypothèses, vérifier les liens entre variables et retrouver des précédents documentés. Pour les équipes réglementaires, la capacité à remonter jusqu’aux documents sources constitue également un atout, car chaque réponse peut être associée à une trace de preuve.
Mais l’approche n’élimine pas les risques. L’unification de bases propriétaires avec des dépôts ouverts et non structurés exige une normalisation rigoureuse. Sans gouvernance de schéma, certaines relations peuvent être mal mappées, ce qui augmente le risque d’interprétations incorrectes ou de réponses trompeuses.
Les coûts doivent aussi être pris en compte. Un graphe Neptune Analytics configuré avec des ressources mémoire dédiées entraîne des dépenses opérationnelles horaires. À cela s’ajoutent les environnements de développement, le stockage et la consommation dynamique de tokens liée aux modèles utilisés pour les requêtes, les résumés et la génération de réponses.
Conclusion : un modèle au-delà de la pharmacie
Le cas GraphRAG AWS montre comment l’IA générative peut dépasser le simple chatbot documentaire. En structurant les données dans un graphe de connaissances, l’entreprise obtient une interface de recherche capable de relier questions, sources, entités et raisonnements.
Pour la pharmacie, l’intérêt est immédiat : accélérer la découverte, préserver la mémoire scientifique et renforcer la traçabilité. Mais le modèle peut s’étendre à d’autres secteurs confrontés à des systèmes anciens, des documents dispersés et des exigences de conformité élevées.
La condition de réussite reste claire : la performance ne dépend pas seulement du modèle de langage, mais de la qualité du graphe, de la gouvernance des données et de la capacité à vérifier chaque résultat. Dans ce cadre, GraphRAG AWS devient moins une simple solution d’IA qu’une infrastructure de connaissance pour les organisations complexes.
Articles connexes
NVIDIA Hugging Face : quels enjeux du rachat à 12,93 Md$
Kimi K3 open-weight : l'IA chinoise mise sur la mémoire
IA agentique : Microsoft accélère avec la puce Majorana 2
Demand Gen : Google mise sur l’IA pour remplacer Display
Outils recommandés
Hugging Face
Hugging Face est une plateforme collaborative pour modèles ML et NLP qui propose un hub de modèles open-source, des datasets, une API d'inférence et des Spaces pour déployer des applications ML rapidement.
Voir l'outilClaude Mythos
Modèle IA avancé d’Anthropic pour la recherche en cybersécurité, l’analyse de code et l’identification de vulnérabilités, accessible de façon restreinte aux partenaires qualifiés.
Voir l'outil