Kimi K3 open-weight : l'IA chinoise mise sur la mémoire
Kimi K3 open-weight déplace le débat des paramètres vers la mémoire, avec un modèle chinois géant plus ambitieux que simple à déployer.
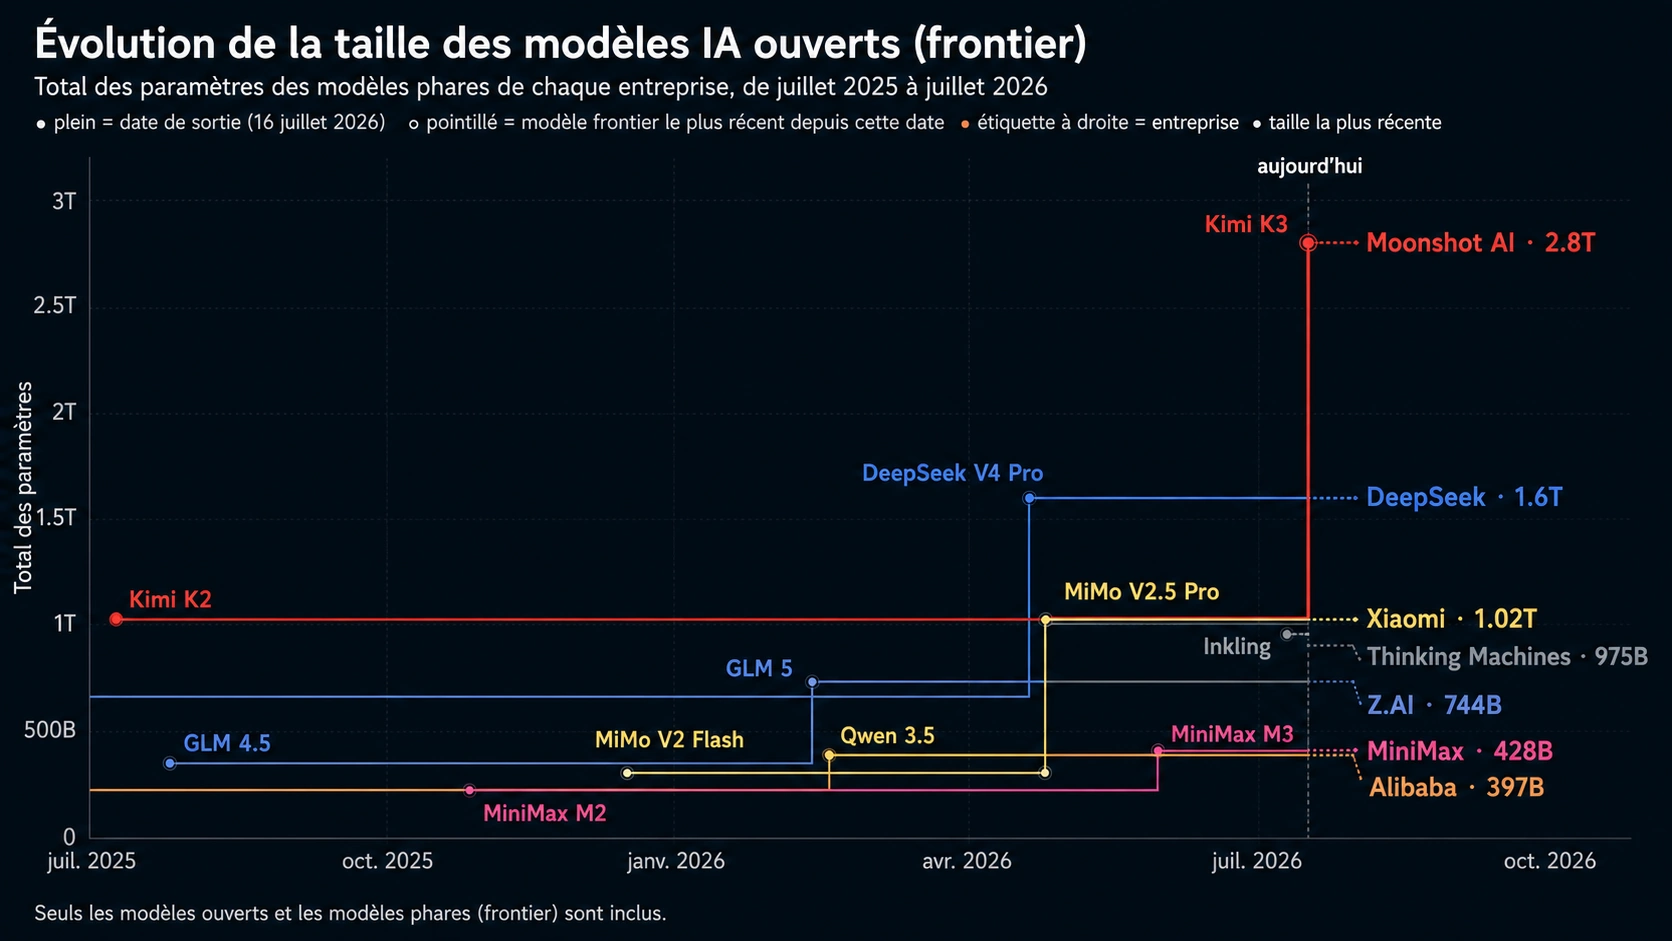
Kimi K3 open-weight marque une étape importante dans la course aux grands modèles d'IA. Présenté par Moonshot AI, ce modèle à poids ouverts revendique 2,8 trillions de paramètres et un contexte pouvant atteindre un million de tokens. Mais derrière ce chiffre spectaculaire, l'enjeu central n'est pas seulement la puissance de calcul. Il concerne surtout la mémoire nécessaire pour faire fonctionner un tel système à grande échelle.
Pourquoi Kimi K3 open-weight est d'abord un défi mémoire
Dans un grand modèle de langage, deux contraintes dominent les coûts d'exploitation. La première est le calcul nécessaire pour générer chaque token. La seconde est la capacité à garder les paramètres disponibles en mémoire pendant l'exécution. Kimi K3 open-weight illustre précisément ce déplacement du problème : réduire le calcul ne suffit pas si l'ensemble du modèle doit rester chargé.
Moonshot AI utilise une architecture de type mixture-of-experts. Le principe consiste à diviser le modèle en 896 experts spécialisés, tout en n'en activant que 16 à chaque étape. En pratique, cela signifie qu'environ 1,8 % du modèle est sollicité pour produire un token. Le gain en calcul est donc important, mais la contrainte mémoire reste massive, car les 2,8 trillions de paramètres doivent être prêts à être appelés.
La réponse de Moonshot passe aussi par l'entraînement en précision réduite. Kimi K3 est conçu pour fonctionner avec 4 bits par paramètre, au lieu de formats plus lourds comme le 16 bits. Selon des analyses indépendantes citées autour du lancement, les poids représenteraient environ 1,4 To dans ce format, contre 5,6 To à pleine précision. Cette optimisation rend le modèle plus réaliste à servir, sans le rendre léger pour autant.
Une architecture pensée pour contourner les limites matérielles
Le choix de la mémoire n'est pas anodin. Les restrictions américaines sur les puces avancées ont fortement réduit l'accès des acteurs chinois aux accélérateurs les plus performants. Dans ce contexte, Kimi K3 ne supprime pas la contrainte matérielle : il la déplace vers une ressource qui peut être mutualisée sur un grand nombre de puces.
Moonshot recommande de faire tourner le modèle sur au moins 64 accélérateurs interconnectés, afin qu'ils agissent comme un pool unique. Cette approche ressemble à celle d'infrastructures cherchant à agréger de nombreuses puces moins remarquables individuellement. Le calcul de pointe reste difficile à remplacer, mais la mémoire peut être additionnée plus facilement, à condition de disposer d'une interconnexion suffisamment rapide.
Autre élément clé : Kimi Delta Attention. Cette technique vise la mémoire utilisée pendant les très longs contextes. Lorsqu'un modèle lit un document de plusieurs milliers de pages, il doit conserver l'historique déjà traité. À un million de tokens, ce cache peut devenir plus lourd que le modèle lui-même. Moonshot affirme que cette approche accélère fortement le décodage sur de longs contextes et l'associe à des mécanismes de cache intégrés aux outils d'inférence. Le projet vLLM, largement utilisé pour servir des modèles, fait partie des environnements concernés.
Ce que les entreprises peuvent réellement déployer
Pour les entreprises, la question n'est pas seulement de savoir si Kimi K3 est impressionnant sur le papier. Elle est de déterminer si un modèle à poids ouverts de cette taille peut réellement être hébergé en interne. Les poids ouverts attirent les organisations pour des raisons de coût, de souveraineté des données et de personnalisation, notamment dans les secteurs réglementés.
Le problème est que Kimi K3 ressemble davantage à un projet de centre de données qu'à une installation classique dans une salle serveur. Les poids seuls exigent environ 1,4 To de mémoire dans le format annoncé. Il faut ensuite ajouter la mémoire nécessaire au contexte, aux caches, aux requêtes simultanées et à l'orchestration sur plusieurs accélérateurs.
Pour une organisation, les implications concrètes sont claires :
- prévoir une infrastructure multi-accélérateurs très étroitement interconnectée ;
- distinguer la date de disponibilité des poids et la date de déploiement opérationnel ;
- tester la compatibilité des outils d'inférence avant toute mise en production ;
- budgéter le coût par tâche complète, pas seulement le prix par token ;
- évaluer si l'hébergement dédié répond mieux aux exigences de conformité.
Moonshot indique travailler avec des partenaires d'inférence et des mainteneurs open source afin d'aligner les détails techniques avant la disponibilité des poids. Autrement dit, l'ouverture du modèle ne signifie pas automatiquement une exploitation simple. Pour beaucoup d'acteurs, la voie réaliste passera par de la capacité dédiée louée auprès d'un fournisseur, tout en conservant les données dans une juridiction définie.
Performances, prix et limites encore à vérifier
Kimi K3 a déjà attiré l'attention par ses résultats en génération de code frontend, où il s'est classé en tête d'une évaluation Arena avec 1 679 points. Ce résultat est notable, mais il concerne un domaine précis. Il ne suffit pas à conclure à une supériorité générale du modèle sur toutes les tâches.
Moonshot reste d'ailleurs prudent dans sa communication technique. La société reconnaît que les performances globales de Kimi K3 restent derrière certains modèles propriétaires de référence. Elle mentionne aussi plusieurs limites : une qualité de génération instable si l'historique de raisonnement n'est pas correctement retransmis, des décisions inattendues lorsque l'intention utilisateur est ambiguë, et un écart d'expérience utilisateur face aux meilleurs modèles fermés.
Le positionnement tarifaire confirme aussi que Kimi K3 n'est plus un modèle économique d'entrée de gamme. Les prix annoncés atteignent 3 dollars par million de tokens en entrée, 0,30 dollar lorsque l'entrée est déjà en cache, et 15 dollars par million de tokens en sortie. Ce tarif peut rester compétitif face à certains grands modèles, mais il dépasse plusieurs alternatives open-weight ou chinoises plus agressives.
Un autre point compte pour les équipes techniques : Kimi K3 démarre avec un mode de raisonnement maximal comme réglage principal, avec des modes plus légers annoncés plus tard. Les longues chaînes de raisonnement, les essais répétés et les tâches complexes peuvent donc faire grimper rapidement la facture réelle.
Un signal fort pour les modèles à poids ouverts
Kimi K3 open-weight montre que la compétition IA ne se résume plus à empiler davantage de paramètres ou à disposer des puces les plus puissantes. Le modèle met en avant une stratégie différente, fondée sur l'architecture, la quantification, la gestion du cache et la mutualisation de la mémoire.
Cette approche ne rend pas l'IA géante accessible à tous. Elle montre plutôt comment un laboratoire peut chercher à maximiser ses ressources dans un environnement contraint. Les entreprises intéressées devront regarder au-delà du chiffre de 2,8 trillions de paramètres : coût total, maturité logicielle, contraintes matérielles et vérification indépendante des performances seront déterminants.
La publication des poids permettra de mesurer ce qui relève de l'avancée durable et ce qui reste dépendant d'une infrastructure lourde. Dans tous les cas, Kimi K3 confirme une tendance de fond : les modèles ouverts progressent vite, mais leur déploiement à très grande échelle reste une affaire d'ingénierie autant que d'intelligence artificielle.
Articles connexes
Muse Wonder : Meta lance ses nouveaux modèles pour les agents IA
Claude Sonnet 5.5, GPT-6.1 Sol, Gemini 4 Argon : même prix
NVIDIA Hugging Face : quels enjeux du rachat à 12,93 Md$
Gemini 3.6 Flash : Google réduit le coût des agents IA pro
Outils recommandés
Qwen3.7-Max
Modèle de langage avancé d’Alibaba Cloud conçu pour le raisonnement complexe, le codage agentique et l’exécution de tâches longues via API et workflows multi-outils.
Voir l'outilClaude Mythos
Modèle IA avancé d’Anthropic pour la recherche en cybersécurité, l’analyse de code et l’identification de vulnérabilités, accessible de façon restreinte aux partenaires qualifiés.
Voir l'outil