Mistral Large 4 : Mistral publie les poids de Le Chonk
Mistral publie les poids de Mistral Large 4, son modèle de 1 000 milliards de paramètres. Code, licence, matériel et prix : ce qu’il faut savoir.
Mistral AI a publié le 29 octobre 2026 les poids de Mistral Large 4, surnommé « Le Chonk ». Ce modèle de 1 000 milliards de paramètres était en préversion publique depuis début octobre. Il peut maintenant être téléchargé, hébergé sur sa propre infrastructure et adapté, à une condition de licence près. Mistral le présente comme le meilleur modèle à poids ouverts pour le code et met en avant ses usages en cybersécurité défensive. Annonce officielle de Mistral AI.
Ce que Mistral a publié le 29 octobre
Mistral Large 4 est un modèle à mélange d’experts : sur environ 1 000 milliards de paramètres, 49 milliards sont activés par token (52 milliards en comptant les couches d’entrée et de sortie). Selon sa fiche technique sur Hugging Face, il compte 128 experts, dont 4 sont sollicités à chaque token avec un expert partagé. Sa fenêtre de contexte atteint 1 million de tokens. Il accepte du texte et des images en entrée et produit du texte.
La version publiée n’est pas celle de la préversion. Mistral indique avoir ajouté trois semaines d’apprentissage par renforcement, en s’appuyant sur les retours des premiers utilisateurs. Le modèle a été entraîné en Europe sur 3 800 GPU NVIDIA Grace Blackwell, d’après la fiche technique. Il rejoint ainsi la gamme de l’éditeur, présentée sur notre fiche Mistral.
Code et cybersécurité : ce que disent les chiffres de Mistral
Les résultats ci-dessous sont publiés par Mistral. Ils ne constituent pas un test indépendant de ZoneIA, et le rapport technique complet est annoncé « prochainement ».
- Artificial Analysis Coding Agent Index : 48 %, au niveau de GLM-5.3 (49 %) avec, selon Mistral, 47 % de tokens en moins par tâche.
- Terminal-Bench 4.0 : 41 %, soit 13 points de plus que la préversion, avec 30 % de tokens de sortie en moins.
- FrontierCode 2.0, un benchmark privé de Cognition : 19,7 %, en tête du graphique publié par Mistral.
- Artificial Analysis Cyber Index : 51 %, avec un taux de refus moyen de 96,6 % sur des demandes malveillantes en cybersécurité.
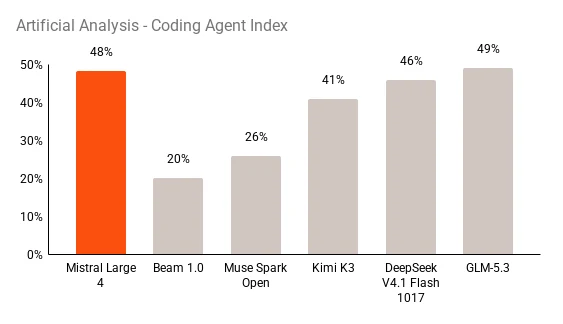
Graphique publié par Mistral AI sur la fiche Hugging Face du modèle. Scores rapportés par l’éditeur.
Le même graphique situe Muse Spark Open, dont Meta a publié les poids le 15 octobre, à 26 % sur cet indice. Le tableau d’ensemble est plus nuancé : sur l’Intelligence Index v5 d’Artificial Analysis, la fiche technique attribue 26 points à Mistral Large 4, contre 32 pour GLM-5.3 et DeepSeek V4.1 Flash. Mistral le décrit comme le meilleur modèle ouvert occidental sur cet indice, pas comme le premier toutes origines confondues. Son point fort revendiqué reste donc le code agentique, avec une consommation de tokens plus faible.
Trois niveaux de raisonnement à choisir
Le modèle propose désormais trois niveaux de raisonnement, réglables à chaque requête :
- Low pour les tâches simples, en remplacement de l’ancien mode sans raisonnement ;
- Medium pour les usages courants ;
- High, par défaut, pour les tâches complexes ou agentiques.
Ce réglage compte pour le coût réel : la fiche technique précise que la limite de tokens générés inclut le raisonnement et la réponse visible. Mistral recommande une température de 1,0 et un top_p de 0,95, quel que soit le niveau choisi.
Comment l’essayer : API, Vibe Code ou vos propres serveurs
Par API. Le modèle est accessible via Mistral Studio et l’API Mistral, mais aussi sur OpenRouter, sur les points d’accès hébergés par NVIDIA et sur Microsoft Foundry. L’annonce affiche un tarif de 0,70 $ par million de tokens en entrée, 0,07 $ en entrée mise en cache et 2,10 $ en sortie.
Dans Vibe Code. Mistral invite à tester le modèle dans Vibe Code, l’agent de développement de son assistant, en lui confiant une fonction à écrire ou un bug à corriger dans un dépôt.
Sur vos serveurs. Les poids sont téléchargeables sur Hugging Face et se servent avec vLLM ou SGLang. Les exemples de la fiche supposent un nœud de 8 GPU. Une version quantifiée NVFP4 vise les GPU NVIDIA Blackwell ; selon The Next Web, elle fonctionne sur quatre GPU B200 ou B300. Des conversions GGUF existent, mais ce modèle reste destiné aux serveurs, pas à un ordinateur personnel. Mistral prévoit des versions distillées plus petites, dont une pour ordinateur portable, sans date annoncée.
Une licence ouverte, avec une condition
Mistral Large 4 est distribué sous la Mistral Ecosystem Open-Weight License, une licence MIT modifiée. Elle autorise l’usage, la modification, l’entraînement complémentaire et la commercialisation du modèle et de ses dérivés. Une condition s’ajoute : une entreprise qui exploite une offre de modèle en tant que service doit signer une licence commerciale distincte avec Mistral avant tout usage commercial.
Le texte définit ce service comme l’accès donné à un tiers pour l’inférence ou le post-entraînement, avec un contrôle significatif sur les entrées, les paramètres ou les données. Les usages internes en sont exclus, tout comme les produits qui intègrent le modèle dans une fonction précise et l’accès via les produits officiels de Mistral. Texte de la licence.
Comme pour les autres grands modèles récents, il est donc plus juste de parler de poids ouverts que d’open source au sens strict. Notre définition de l’open source en IA détaille cette distinction.
À qui s’adresse cette sortie, et ses limites
Pour une entreprise ou une administration européenne, l’intérêt principal est le contrôle : héberger le modèle chez soi, l’adapter à ses données et éviter de dépendre d’une API. Mistral cite des acteurs de la sécurité comme Orange Cyberdefense, Cisco, CrowdStrike ou l’ENISA ; cette dernière dit le tester pour auditer du code et analyser des journaux. Pour un développeur, le plus simple reste de commencer par l’API ou Vibe Code sur une tâche vérifiable, avant d’envisager un hébergement coûteux.
Trois limites ressortent de l’annonce elle-même. D’abord, Mistral reconnaît qu’après avoir observé le trafic de la préversion, il voit un risque d’aide à des attaques réelles, et ajuste ses garde-fous. Ensuite, une variante spécialisée pour les tests d’intrusion reste réservée à des partenaires vérifiés, sous contrat. Enfin, faute de rapport technique publié, les performances annoncées restent à confirmer par des évaluations indépendantes et sur vos propres cas d’usage.
Pour mesurer le chemin parcouru, notre article de février 2024 sur le premier Mistral Large revient sur ses débuts face à GPT-4.
Couverture : illustration générée avec ImageGen pour ZoneIA. Graphique intérieur : Mistral AI.
Sources
Articles connexes
Muse Spark Open : Meta ouvre son modèle pour les agents IA
NVIDIA PAIR 1.0 : exécuter l’IA locale sur plusieurs PC
Muse Wonder : Meta lance ses nouveaux modèles pour les agents IA
Claude Sonnet 5.5, GPT-6.1 Sol, Gemini 4 Argon : même prix
Outils recommandés
Qwen3.7-Max
Modèle de langage avancé d’Alibaba Cloud conçu pour le raisonnement complexe, le codage agentique et l’exécution de tâches longues via API et workflows multi-outils.
Voir l'outilClaude Mythos Preview
Modèle IA avancé d’Anthropic pour la recherche en cybersécurité, l’analyse de code et l’identification de vulnérabilités, accessible de façon restreinte aux partenaires qualifiés.
Voir l'outil