Voxtral 3, Gemini Notebook et Mercury 3 : 3 nouveautés IA
Mistral transcrit la voix en direct, Gemini Notebook montre le plan avant de générer, Mercury 3 écrit en parallèle : ce qui change et les limites.
Trois annonces des 19 et 20 octobre 2026 visent le même objectif : faire gagner du temps sur des tâches très concrètes. Mistral transcrit la voix presque en direct avec Voxtral 3, Google ajoute une étape de relecture dans Gemini Notebook, et Inception présente Mercury 3, un modèle qui n’écrit pas mot à mot. Voici ce qui change, pour qui, et les limites à garder en tête.
Voxtral 3 : la voix transcrite en direct, en français
Mistral AI a publié Voxtral 3 le 20 octobre 2026. Il s’agit d’une famille de modèles audio pour les applications et les agents vocaux :
- Voxtral Small Transcribe 3 transcrit plus de 50 langues, dont les 24 langues officielles de l’Union européenne, et identifie les différents interlocuteurs d’un enregistrement. On peut aussi lui fournir des noms propres ou du vocabulaire métier pour améliorer la transcription.
- Voxtral Mini Transcribe Realtime 3 transcrit en direct avec une latence inférieure à 500 millisecondes dans plus de 35 langues, dont le français, et détecte la fin d’une prise de parole.
- Voxtral Speech 3 fait l’inverse : il synthétise une voix à partir d’un texte, avec des voix prêtes à l’emploi en français.
- Un SDK d’agents vocaux relie transcription, modèle de langage et synthèse vocale pour construire un assistant qui écoute, agit et répond.
Pour un public francophone, l’intérêt est double : le français fait partie des langues mises en avant, et Mistral propose un hébergement sur son infrastructure européenne. Si la notion vous est peu familière, notre définition de la reconnaissance vocale résume le principe.
Limites. Voxtral 3 s’adresse d’abord aux développeurs et aux entreprises : il est accessible par l’API de Mistral et son studio de test, l’auto-hébergement passant par l’équipe commerciale. Mistral n’indique pas, à ce stade, d’intégration dans son application grand public Vibe. Les comparaisons de précision (face à Whisper ou aux modèles de Google et d’OpenAI) sont des mesures publiées par Mistral, en partie internes, et la page annonce selon les endroits 35 ou 40 langues pour le temps réel.
Gemini Notebook : relire le plan avant de générer
Le 19 octobre, Google a présenté une manière plus contrôlée de créer des présentations et des résumés vidéo dans Gemini Notebook, l’ancien NotebookLM. Le principe tient en trois temps :
- On demande des diapos ou une vidéo dans la conversation ; Gemini Notebook propose des sujets à partir des sources du carnet.
- Avec l’option Review activée, il affiche d’abord le plan : les notes de plan pour les diapos, les notes de production pour une vidéo.
- On demande des changements, comme ajouter un résumé ou réordonner des scènes, puis on lance la génération.
L’intérêt est pratique : on corrige la structure avant d’attendre le résultat, au lieu de régénérer une présentation entière parce qu’une partie manque. Le mode rapide reste disponible pour ceux qui préfèrent générer directement.
Limites. Google annonce un déploiement mondial à tous les utilisateurs de Gemini Notebook au cours de la semaine suivant le 19 octobre : la fonction peut donc ne pas encore apparaître sur votre compte. Surtout, l’aide officielle précise que la co-création des résumés vidéo est réservée aux abonnés Google AI Ultra, alors que l’annonce parle de tous les utilisateurs. Les vidéos peuvent aussi demander un long temps de génération, parfois plus de 30 minutes selon Google.
Mercury 3 : un modèle qui écrit tout le texte à la fois
Inception, une start-up américaine, a lancé Mercury 3 le 19 octobre. Sa particularité tient à sa méthode. La plupart des modèles de langage produisent leur réponse un morceau après l’autre. Mercury 3 est un modèle à diffusion : il génère plusieurs morceaux du texte en parallèle, puis les affine, une approche proche de celle des générateurs d’images. Notre définition du modèle de diffusion détaille cette famille de techniques.
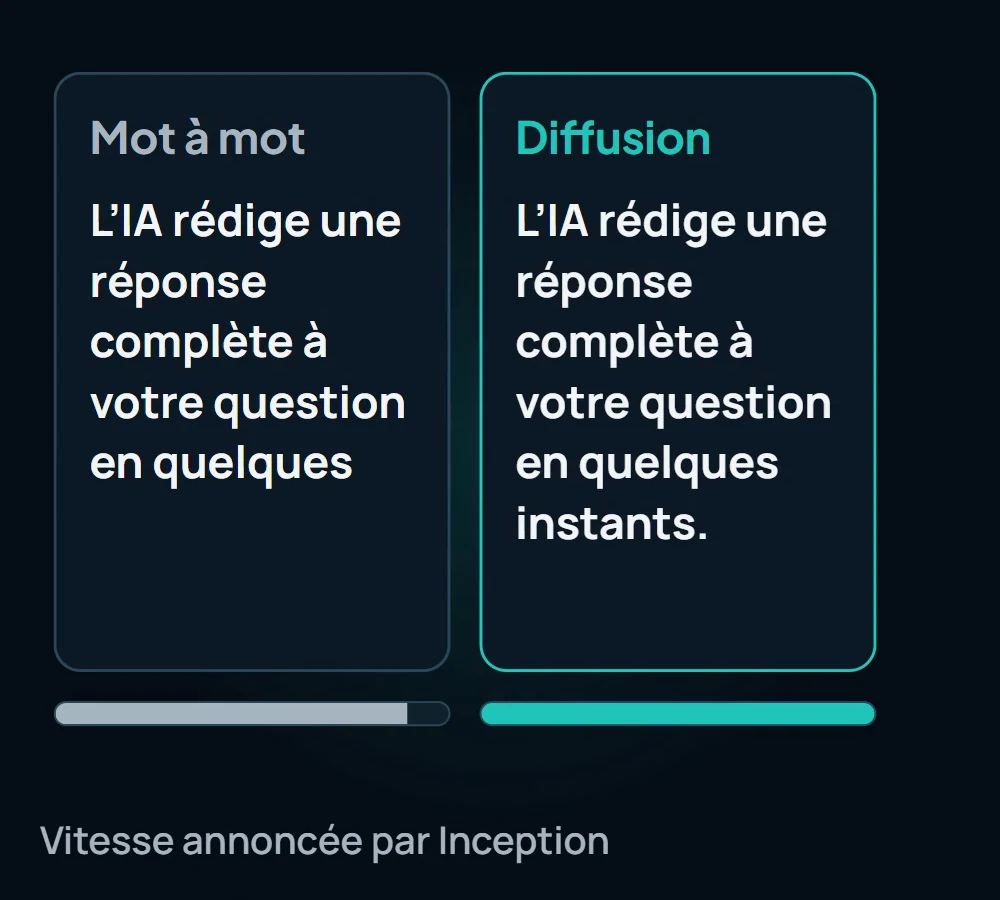
Principe illustré par ZoneIA, extrait de notre vidéo : ce schéma explique la méthode, il ne mesure pas la vitesse de Mercury 3.
Inception annonce 1 068 tokens par seconde sur des GPU NVIDIA, un contexte d’un million de tokens et des performances au niveau de modèles rapides concurrents. Le modèle est accessible par l’API d’Inception, avec 100 millions de tokens offerts à l’inscription, ainsi que via OpenRouter, Baseten et Vercel ; un chat en ligne permet aussi de l’essayer.
Limites. Ces chiffres sont mesurés par Inception et n’ont pas été reproduits de façon indépendante. Un premier essai publié par The Neuron décrit une API rapide, mais relève aussi des erreurs de calcul et de consigne. Pour un usage courant, la vitesse ne remplace pas la vérification des réponses.
Ce qu’il faut retenir
- Voxtral 3 (Mistral, 20 octobre) : transcription en plus de 50 langues et en direct en moins d’une demi-seconde selon Mistral, pour les applications vocales via l’API.
- Gemini Notebook (Google, 19 octobre) : le plan des diapos s’affiche avant la génération pour être corrigé ; la co-création vidéo est réservée à Google AI Ultra.
- Mercury 3 (Inception, 19 octobre) : génération de texte en parallèle plutôt que mot à mot, avec une vitesse annoncée par l’éditeur.
Écouter, préparer, écrire : laquelle de ces nouveautés vous servirait en premier ?
Crédits : illustration de couverture générée avec ImageGen pour ZoneIA. Vidéo et schéma Mercury : ZoneIA, animations explicatives qui illustrent le principe de chaque annonce, sans capture des produits.
Sources
- Mistral AI : Voxtral 3, 20 octobre 2026.
- Google : How to shape your slides and videos with Gemini Notebook, 19 octobre 2026.
- Aide Gemini Notebook : résumés vidéo et co-création.
- Inception : Introducing Mercury 3, 19 octobre 2026.
- Rapport technique d’Inception sur les modèles Mercury (arXiv).
- The Neuron : essai de Mercury 3.
Articles connexes
NVIDIA PAIR 1.0 : exécuter l’IA locale sur plusieurs PC
Modèles OpenAI en Chine : le pari stratégique de Microsoft
IA générative Google Cloud : l’urbanisme public accéléré
Microsoft Scout : l’agent IA autonome se teste dans M365
Outils recommandés
Slack AI
Slack AI intègre des fonctionnalités d'IA dans Slack pour résumer les longs fils de discussion, effectuer des recherches dans l'historique, générer des réponses et accélérer la collaboration d'équipe.
Voir l'outilClaude Code
Claude Code d'Anthropic est un assistant de développement agentique en ligne de commande : il lit, édite, teste et soumet des PRs directement depuis votre terminal, avec intégration GitHub/GitLab et exécution locale sécurisée.
Voir l'outil