Gemini 3.6 Flash : Google réduit le coût des agents IA pro
Gemini 3.6 Flash cible les agents IA d’entreprise avec moins de tokens, plus de vitesse et une meilleure efficacité pour le code.
Gemini 3.6 Flash marque une nouvelle étape dans la course aux modèles d’IA pensés pour les agents autonomes en entreprise. Avec cette version, Google ne cherche pas seulement à améliorer les performances brutes : l’objectif est aussi de réduire le coût opérationnel des workflows IA qui tournent en continu, parfois des milliers de fois par heure.
Dans les environnements de production, chaque token généré compte. Un agent capable de planifier, lire des documents, modifier du code ou interagir avec un système doit rester fiable, rapide et économiquement soutenable. C’est précisément sur cet équilibre que Google positionne ses nouveaux modèles Gemini, avec une gamme plus segmentée entre raisonnement avancé, exécution à grand volume et cybersécurité.
Gemini 3.6 Flash cible les agents IA d’entreprise
Avec Gemini 3.6 Flash, Google s’adresse d’abord aux équipes qui déploient des agents IA en arrière-plan plutôt que de simples interfaces conversationnelles. Ces agents doivent enchaîner des tâches complexes, traiter des données variées et produire des résultats exploitables sans créer une facture excessive.
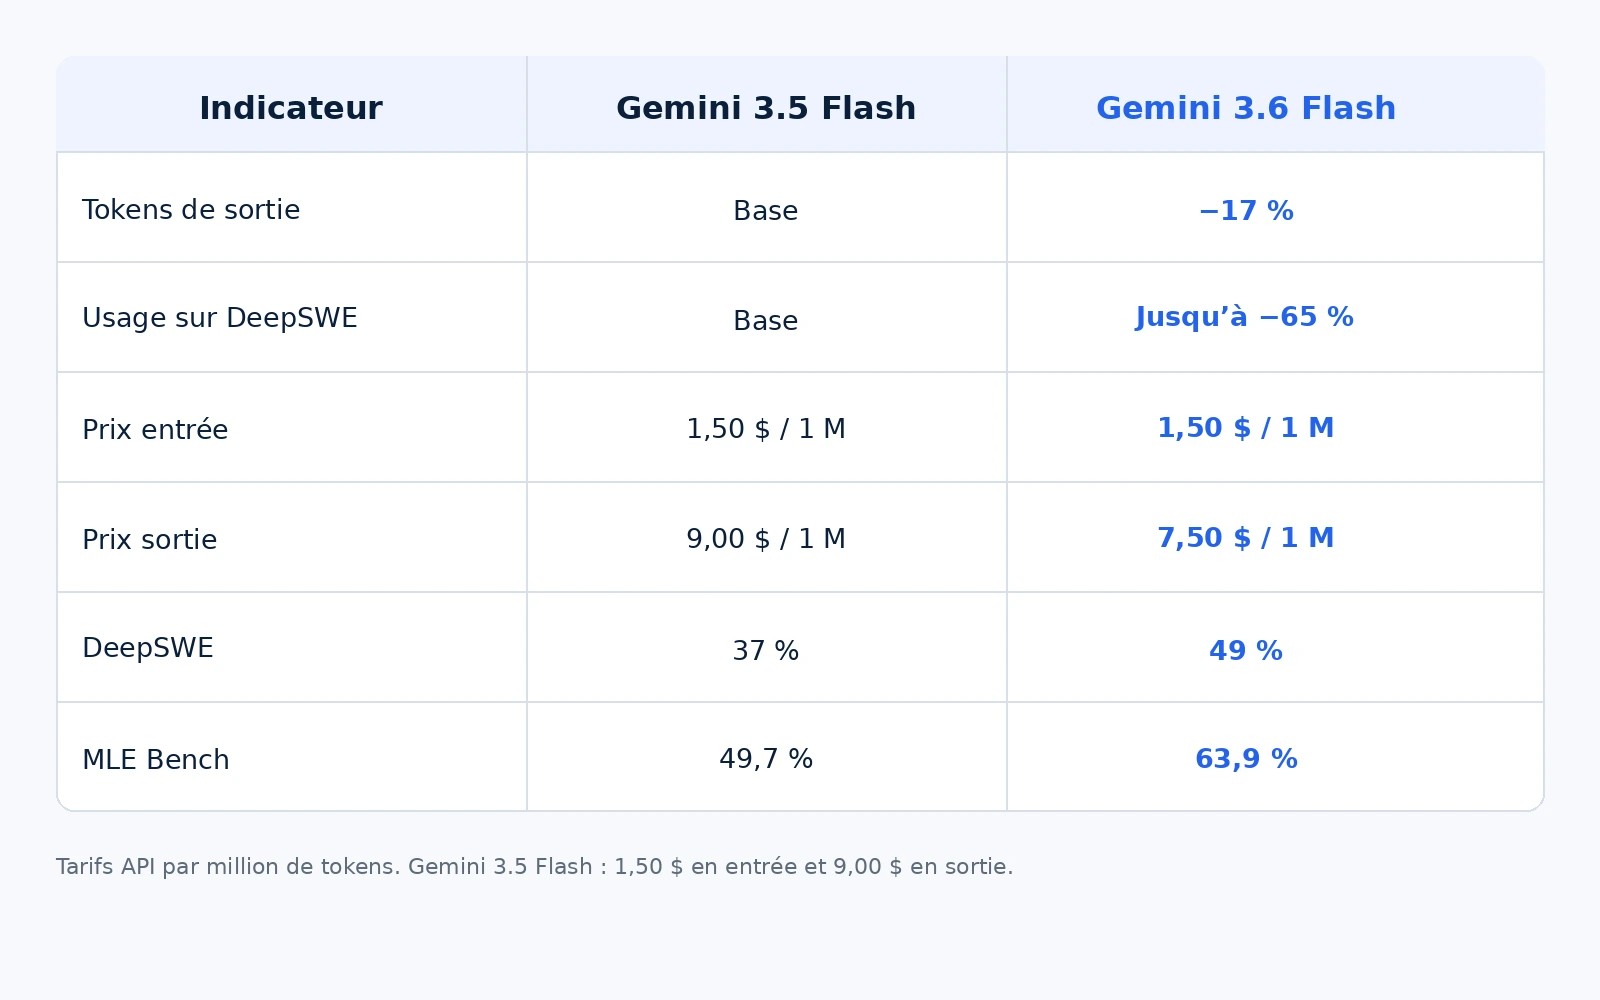
Le point central annoncé par Google est une réduction de 17 % des tokens de sortie par rapport à Gemini 3.5 Flash, selon les mesures de l’Artificial Analysis Index. Cette baisse peut avoir un impact important à grande échelle, car les tokens de sortie sont généralement plus coûteux que les tokens d’entrée.
Sur certains tests synthétiques, comme Datacurve DeepSWE, Google indique même des réductions d’usage de tokens pouvant atteindre 65 %. Le modèle est tarifé à 1,50 dollar par million de tokens d’entrée et 7,50 dollars par million de tokens de sortie, un positionnement conçu pour des boucles de raisonnement fréquentes et automatisées.
Les performances progressent également. Sur DeepSWE, Gemini 3.6 Flash atteint 49 % de réussite contre 37 % pour la version précédente. Sur MLE Bench, le score passe de 49,7 % à 63,9 %. Sur GDPval-AA v2, un test orienté vers des tâches de connaissance proches du monde professionnel, le modèle atteint 1421 points contre 1349 auparavant.
Un modèle optimisé pour le code, le multimodal et les workflows
Gemini 3.6 Flash vise particulièrement les cas d’usage mêlant raisonnement, code et analyse multimodale. Google met en avant son intégration dans des environnements où l’IA doit comprendre des fichiers, interpréter des documents, analyser des graphiques ou générer des étapes de travail pour des équipes métiers.
Figma utilise le modèle dans son infrastructure de prototypage. L’enjeu est d’aider les développeurs à accélérer les cycles d’itération sans dégrader la qualité des résultats produits. Dans ce type de contexte, le gain ne se limite pas à la vitesse : il concerne aussi la fluidité entre conception, test et modification.
D’autres usages concernent les documents complexes. Des plateformes comme Harvey et Hebbia exploitent Gemini 3.6 Flash pour traiter des dossiers financiers, reconnaître la structure de documents, lire des graphiques intégrés et produire des brouillons de rapports destinés à être relus.
Google a également intégré un outil d’usage d’ordinateur côté client dans l’API Gemini et les plateformes Gemini Enterprise. Cette évolution réduit le besoin de logiciels intermédiaires personnalisés, auparavant nécessaires pour permettre à un modèle d’agir sur un système d’exploitation. Les développeurs peuvent consulter les ressources officielles via la documentation Gemini API.
Gemini 3.5 Flash-Lite mise sur le volume et la latence
À côté de Gemini 3.6 Flash, Google introduit Gemini 3.5 Flash-Lite, un modèle pensé pour les tâches à très fort volume. Il ne vise pas prioritairement le raisonnement profond, mais les traitements rapides et répétitifs, comme l’analyse documentaire simple ou la recherche agentique.
Selon l’Artificial Analysis Index, Gemini 3.5 Flash-Lite atteint 350 tokens de sortie par seconde, ce qui en fait le modèle le plus rapide de la série 3.5 d’après Google. Cette caractéristique le rend adapté aux sous-agents qui exécutent de nombreuses requêtes courtes, avec un niveau minimal de raisonnement.
Son prix reflète cette orientation : 0,30 dollar par million de tokens d’entrée et 2,50 dollars par million de tokens de sortie. Pour les équipes techniques, cela permet de répartir les tâches entre plusieurs niveaux de modèles : les opérations simples peuvent être confiées à Flash-Lite, tandis que les tâches plus complexes restent attribuées à Gemini 3.6 Flash.
Les principaux cas d’usage mis en avant sont :
- le traitement massif de documents internes ;
- la recherche automatisée dans de grands corpus ;
- les sous-agents à faible coût ;
- les workflows nécessitant une faible latence ;
- les tâches répétitives avec peu d’ambiguïté.
Sur le test long contexte GDM-MRCR v2, Gemini 3.5 Flash-Lite atteint 72,2 % de réussite contre 60,1 % pour son prédécesseur. Son score GDPval-AA v2 progresse aussi fortement, de 642 à 1140, signe que Google cherche à améliorer la pertinence métier même sur ses modèles les plus économiques.
Cybersécurité : un modèle restreint pour corriger le code
Google présente aussi Gemini 3.5 Flash Cyber, une variante spécialisée dans la validation et la correction de vulnérabilités logicielles. Ce modèle s’adresse à un problème bien connu des équipes de sécurité : les scanners détectent souvent les failles plus vite que les développeurs ne peuvent les corriger.
Gemini 3.5 Flash Cyber est conçu pour analyser du code vulnérable, proposer des remédiations et contribuer à accélérer le patching. Google indique que ses performances sur le benchmark CyberGym sont compétitives avec celles de modèles de pointe, sans toutefois publier le même niveau de détail chiffré que pour ses autres annonces.
La distribution reste limitée aux gouvernements et à des partenaires sélectionnés dans le cadre d’un programme pilote. Google présente cette restriction comme une mesure de sécurité, afin de réduire le risque que le modèle soit utilisé pour générer du code offensif ou faciliter l’exploitation de failles.
Dans CodeMender, l’agent de sécurité de Google, plusieurs instances de Gemini 3.5 Flash Cyber peuvent fonctionner en parallèle. Elles comparent leurs analyses avant de produire un rapport de remédiation unique, ensuite validé par un examinateur humain. Cette approche souligne une tendance forte : l’IA de cybersécurité reste encadrée par une supervision humaine.
Ce que cette gamme Gemini change pour les entreprises
La stratégie de Google repose sur une idée simple : les entreprises n’ont pas besoin d’un seul modèle généraliste pour tous les usages, mais d’une combinaison de modèles adaptés à différents niveaux de coût, de vitesse et de complexité.
Gemini 3.6 Flash se place au centre des workflows exigeants, notamment pour le code, les documents multimodaux et les agents capables d’exécuter des tâches en plusieurs étapes. Gemini 3.5 Flash-Lite répond aux besoins de volume, tandis que Gemini 3.5 Flash Cyber cible un domaine critique mais contrôlé.
Les nouveaux modèles sont accessibles via l’API Gemini, Google AI Studio, Android Studio et la plateforme Gemini Enterprise Agent. Certaines fonctionnalités arrivent également dans l’application Gemini, tandis que Flash-Lite commence aussi à être déployé dans Google Search. Les annonces officielles de Google sont disponibles sur le blog Google.
Conclusion : avec Gemini 3.6 Flash, Google met l’accent sur l’efficacité économique des agents IA autant que sur leurs capacités techniques. Pour les entreprises, l’enjeu devient moins de choisir le modèle le plus puissant que de construire une architecture IA capable d’allouer le bon modèle à la bonne tâche, au bon coût.
Articles connexes
Claude Sonnet 5.5, GPT-6.1 Sol, Gemini 4 Argon : même prix
NVIDIA Hugging Face : quels enjeux du rachat à 12,93 Md$
Kimi K3 open-weight : l'IA chinoise mise sur la mémoire
Claude Sonnet 5 : Anthropic relance ses modèles IA avancés
Outils recommandés
Qwen3.7-Max
Modèle de langage avancé d’Alibaba Cloud conçu pour le raisonnement complexe, le codage agentique et l’exécution de tâches longues via API et workflows multi-outils.
Voir l'outilClaude Mythos
Modèle IA avancé d’Anthropic pour la recherche en cybersécurité, l’analyse de code et l’identification de vulnérabilités, accessible de façon restreinte aux partenaires qualifiés.
Voir l'outil